研究员提出新动态二维XR面部表情增强框架,实现更高分辨率细节
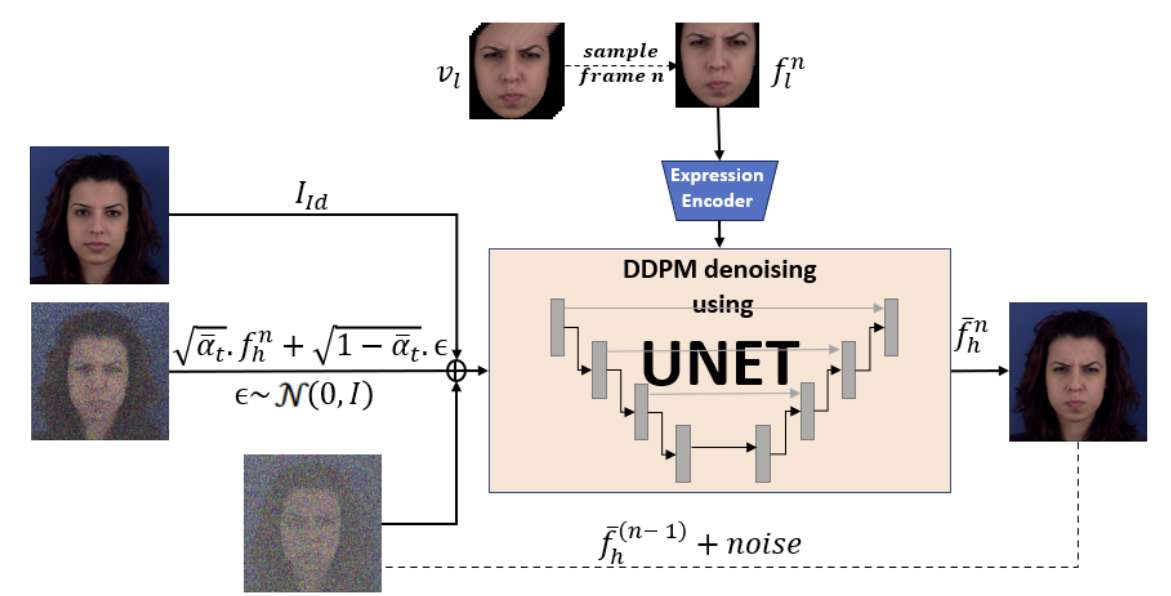
摩洛哥穆罕默德五世大学的研究团队介绍了一种基于扩散的新方法FacEnhance,旨在解决低分辨率面部表情生成模型中的挑战。该方法可以将低分辨率面部表情视频增强到更高分辨率,并结合背景细节提高整体质量。研究人员通过补充轻量级的低分辨率模型,在计算效率和图像质量之间取得了平衡。实验结果表明,FacEnhance可以将低分辨率模型输出提高到最先进的质量。
然而,尽管取得了进展,研究人员承认该方法仍存在一定的局限性,特别是在计算需求和实时适用性方面。未来的研究将集中在通过先进的数据增强技术将模型暴露于更多样化的数据,从而减少失败和扭曲的发生。团队的目标是开发更有效的扩散模型方法,以实现实时适用性并将范围扩展到更高的分辨率。总的来说,FacEnhance为动态二维面部表情增强提供了一种新的框架,成功地提高了视频质量,并同时保留了原始的运动特征。