
韩国团队提出S-Avatar方法,可从单张普通照片生成可驱动、视角可控的3D虚拟化身,解决传统多视角采集复杂及新视角渲染不一致问题。该方法分三阶段:基于扩散模型的高斯泼溅生成初始头部表示,拟合FLAME参数化模型实现对齐,并通过绑定模板将高斯泼溅与FLAME顶点关联,驱动表情和姿态变化。在NeRSemble数据集上,S-Avatar在LPIPS、PSNR和SSIM指标上均领先,重演任务中优于基线,尤其侧面和背面细节重建完整。实际应用中,智能手机照片即可生成化身,结合VR头显实现实时表情驱动,生成时间约197秒,渲染帧率超35帧。局限在于最终质量依赖初始高斯泼溅质量。
本摘要由 AI 自动生成,可能与原文存在偏差。
查看引用/信息源请点击:映维网Nweon
从单张照片到3D Avatar
(映维网Nweon 2026年08月10日)韩国团队日前提出了一种名为S-Avatar的方法,它能够从单张普通照片出发,生成具有完整头部结构、可自由控制表情与视角的3D虚拟化身,为VR/AR应用提供了更便捷的个性化化身创建路径。
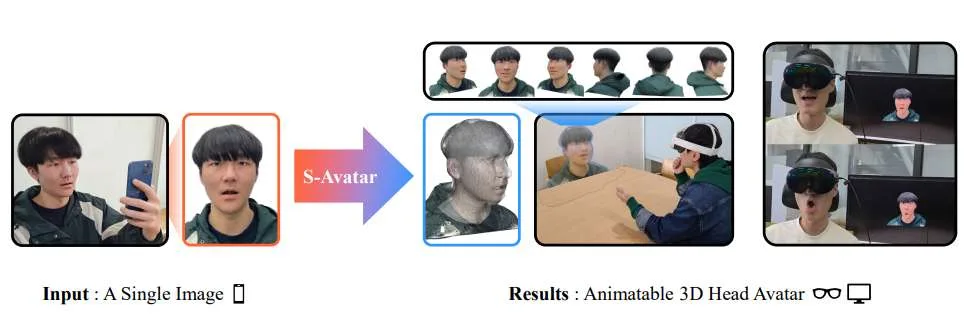
当前,虚拟现实和增强现实应用中,一个能与用户真实外貌高度相似的3D化身是实现沉浸式社交体验的关键。然而,传统的化身重建往往依赖多视角拍摄或长视频序列,采集过程复杂,硬件要求高。尽管近年来基于神经渲染的技术有所突破,但在面对未见过的侧面甚至背面视角时,渲染质量常常明显下降,难以保持3D一致性。
S-Avatar针对这一问题提出了一种三阶段解决方案。首先,系统利用基于扩散模型的高斯泼溅生成模块,从单张RGB图像直接生成一组高分辨率的3D高斯泼溅,作为头部模型的初始几何与外观表示。随后,算法将参数化头部模型FLAME与这些初始泼溅进行拟合,通过优化FLAME的形状、表情与姿态参数,使可驱动的参数化模型与静态3D表示对齐。最后,系统计算一个“绑定模板”,将每个高斯泼溅与周围最近的FLAME顶点建立加权关联,从而使得后续任何FLAME参数的变化——比如新的表情或头部转动——都能自然地驱动3D高斯泼溅产生相应的位移和缩放,最终渲染出逼真的新视角图像。
研究团队在公开的NeRSemble数据集上与当前多种主流方法进行了对比。该数据集包含164名受试者从16个相机视角捕捉的多种表情。在45名受试者的测试集上,S-Avatar在LPIPS(感知相似度,越低越好)、PSNR(峰值信噪比,越高越好)和SSIM(结构相似性,越高越好)三项指标上均取得领先成绩。在重演任务中,无论是同一人物的自我重演还是不同人物间的交叉重演,S-Avatar在保持身份特征和准确传递表情方面均优于基线方法,尤其在侧面和背面视角下,模型能较为完整地重建出耳朵、后脑等容易缺失的细节。
论文,研究展示了该方法的实际应用场景。利用商用智能手机拍摄的日常生活照片,S-Avatar即可生成可驱动的3D化身;结合VR头显的内部传感器数据,系统还能实现实时面部表情驱动。交互式查看器允许用户通过滑块实时调整FLAME参数,控制化身形状、表情和观察角度。
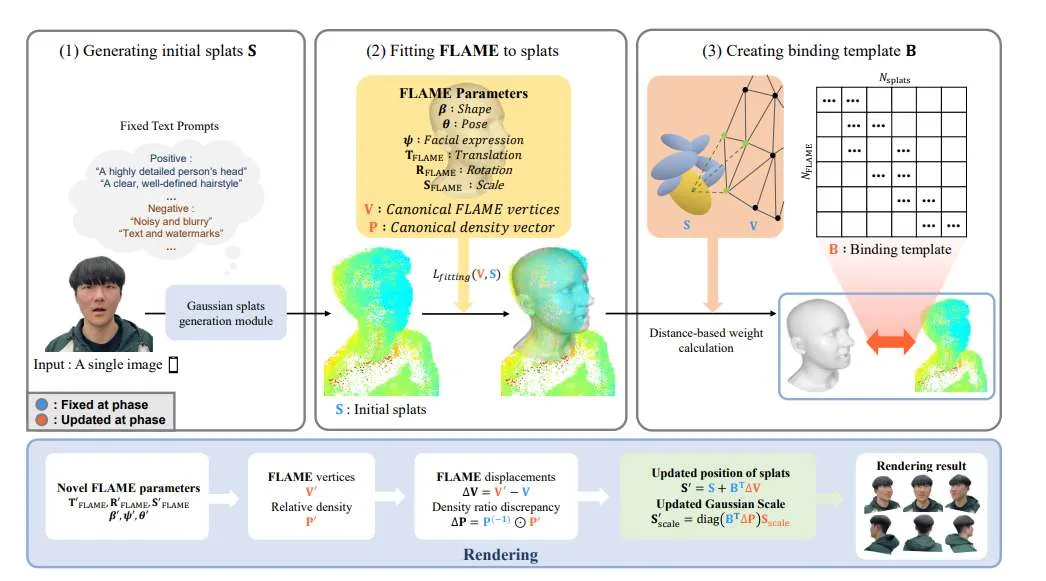
技术细节方面,研究团队通过消融实验确定了绑定过程中最近顶点数量的最优值(10个),并验证了高斯缩放自适应机制对提升表情渲染质量的作用。采用稀疏矩阵存储格式(COO),使得生成时间控制在约197秒,渲染帧率达到35帧以上,支持实时运行。
相关论文:S-Avatar: Diffusion-Guided Gaussian Head Avatars from a Single Image
当然,团队指出了当前方法的局限性:最终生成质量高度依赖于初始3D高斯泼溅的质量,如果生成模块输出不理想,后续流程难以完全弥补。